Novedades WOCU 75
Fecha de Publicación: 30/09/2026
El presente documento presenta un resumen detallado de las nuevas características, funcionalidades, mejoras y correcciones integradas en la versión 75 de WOCU-Monitoring. Con esta actualización, se da respuesta a las peticiones y sugerencias de nuestros usuarios, al mismo tiempo que nos alineamos con las tendencias y necesidades actuales del mercado.
1. Nueva integración MQTT para monitorización pasiva de dispositivos IoT
WOCU-Monitoring incorpora una nueva integración con MQTT, orientada a la monitorización pasiva de dispositivos, especialmente en entornos IoT (Internet of Things).
A diferencia de la monitorización activa, donde WOCU-Monitoring consulta periódicamente a los dispositivos, esta integración permite que sean los propios dispositivos los que publiquen métricas o estados en un broker MQTT. WOCU-Monitoring consume esta información, la enruta al Reino correspondiente y genera automáticamente los Servicios Pasivos asociados.
Esta nueva capacidad facilita la incorporación de dispositivos y fuentes de datos que utilizan MQTT, sin necesidad de disponer previamente de un Pack de monitorización específico.
Esta nueva funcionalidad introduce además:
Una nueva sección MQTT configuration en la configuración avanzada del Reino, donde se definen las credenciales de acceso al broker y el
MQTT Site ID.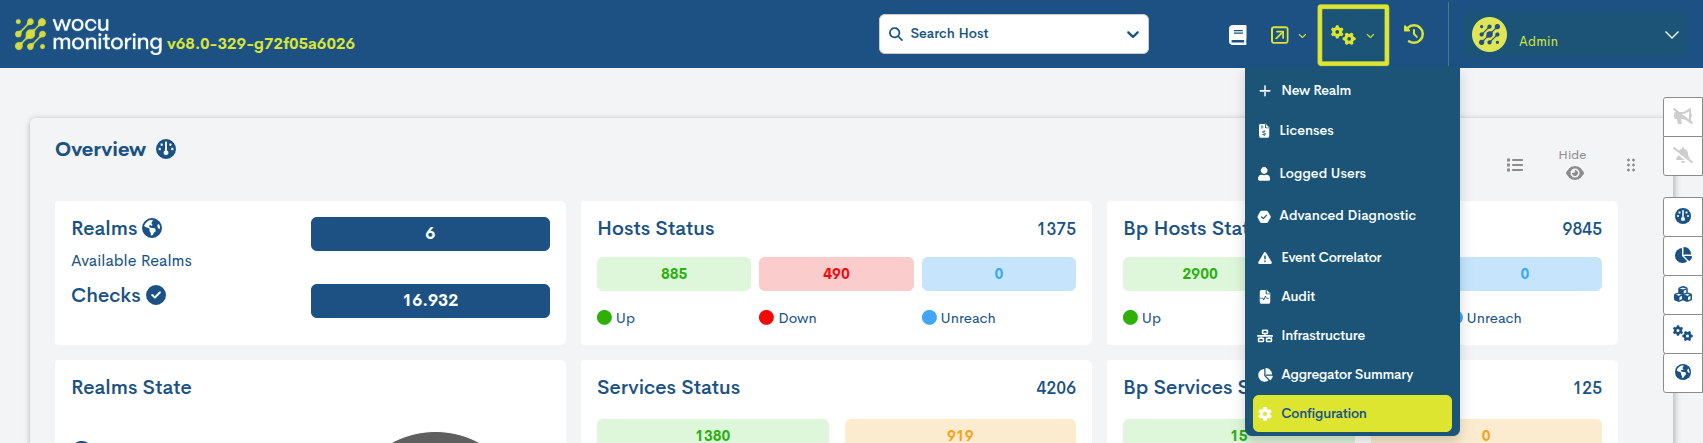
Imagen 1: Acceso a la configuración avanzada del Reino para la integración MQTT.
La nueva Vista MQTT Thresholds, que centraliza los servicios generados mediante MQTT y desde donde se configuran individualmente los umbrales Warning y Critical para cada servicio, con soporte para sintaxis de rangos de Nagios.
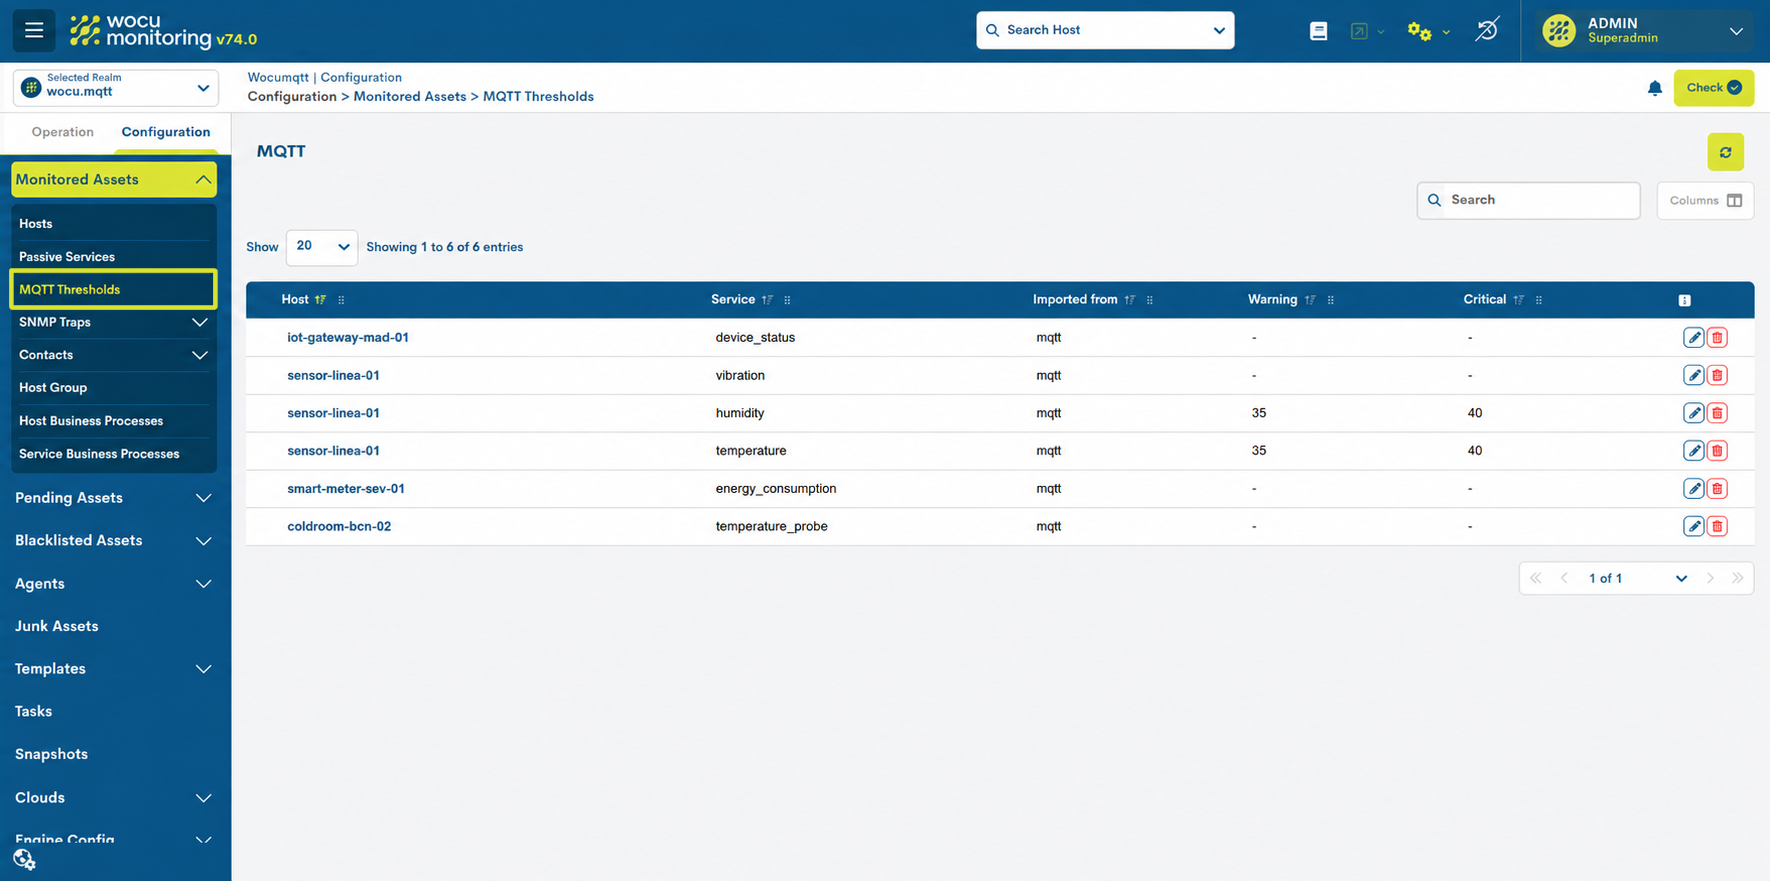
Imagen 2: Vista MQTT Thresholds para la configuración de umbrales Warning y Critical de los servicios MQTT.
Integración de los servicios MQTT en el mismo modelo de estados que el resto de elementos monitorizados por WOCU-Monitoring, permitiendo que cualquier cambio de estado se refleje automáticamente en las vistas de monitorización de Hosts y Servicios, como el Inventario de Dispositivos (Hosts Inventory).

Imagen 3: Visualización de un servicio MQTT integrado en el inventario de Hosts.
2. Nuevas capacidades en las reglas de correlación de eventos
Configuración del límite de tiempo en estado DOWN en reglas de correlación
Se incorpora el nuevo campo Max duration in minutes/hours en el formulario de Creación y configuración de Reglas de correlación de eventos.
Esta opción permite definir el tiempo máximo que un dispositivo puede permanecer en estado hard-DOWN para seguir siendo considerado como afectado por la regla. Una vez superado el intervalo configurado, el dispositivo queda excluido del cálculo de correlación.
Esta mejora complementa al parámetro Duration in minutes/hours, permitiendo establecer un rango temporal mínimo y máximo para determinar qué dispositivos deben tenerse en cuenta durante la evaluación de la regla.
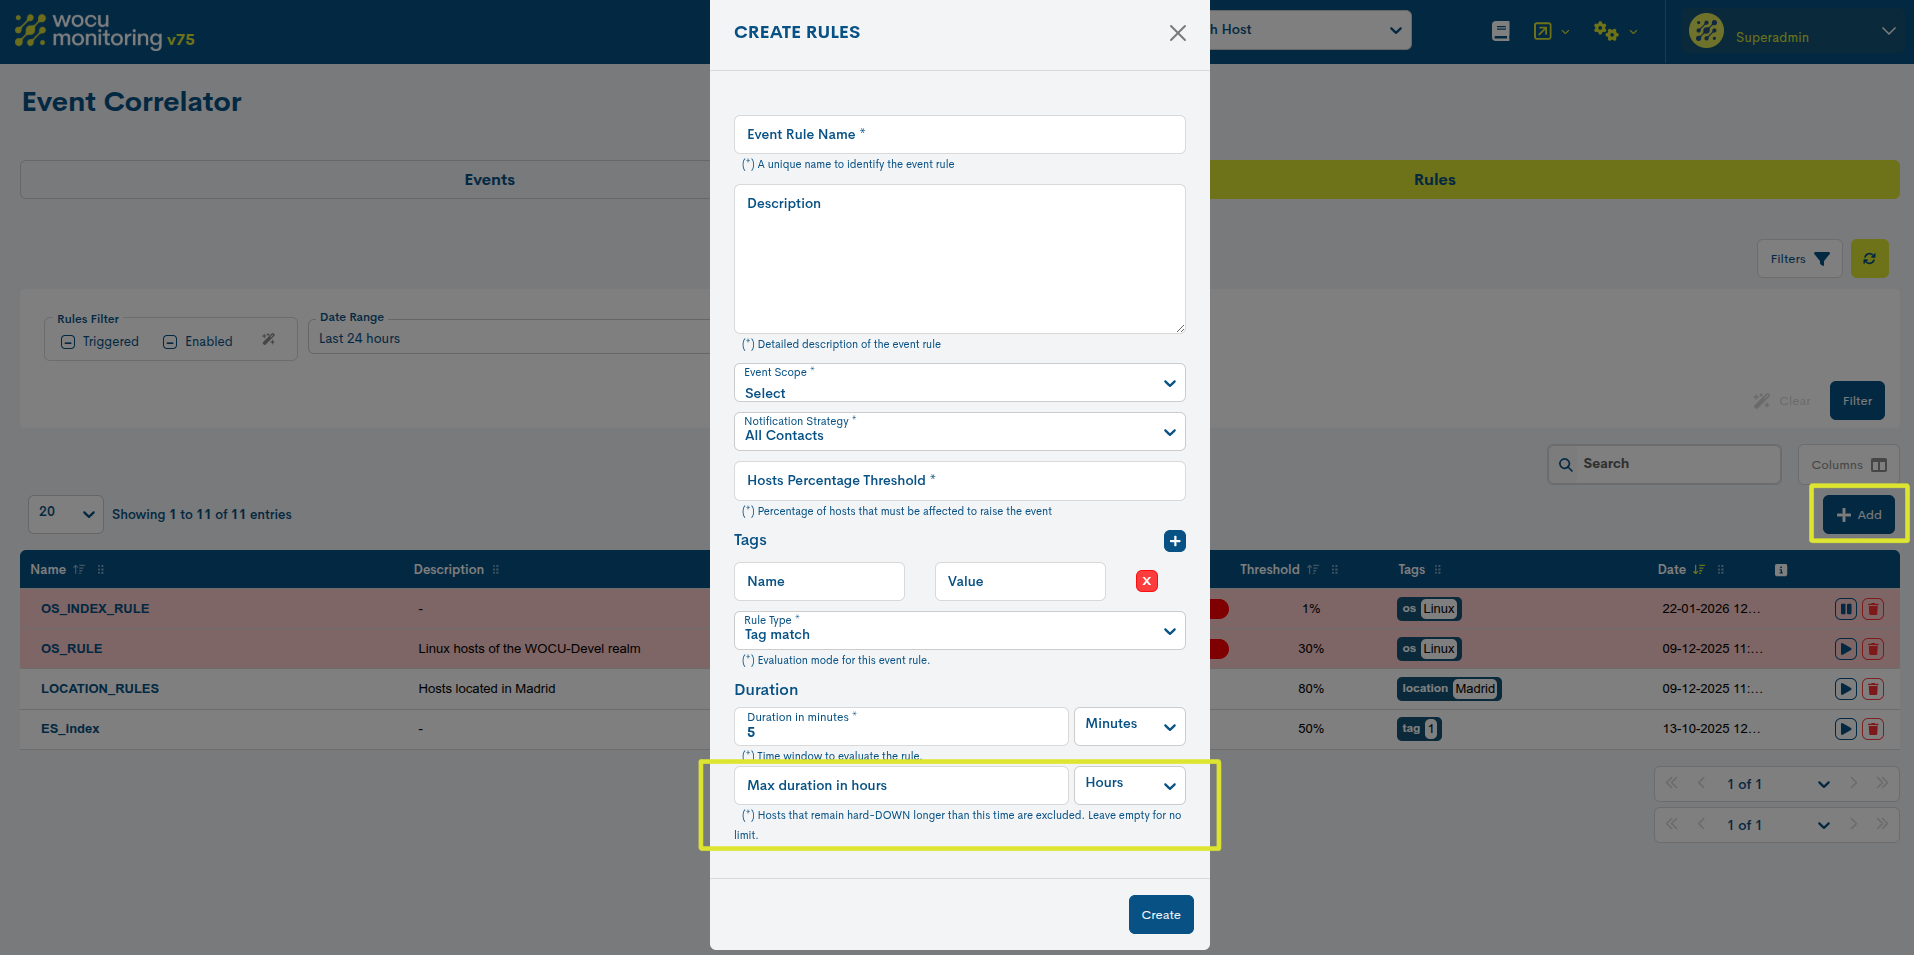
Imagen 4: Configuración de la duración máxima en una regla de correlación de eventos.
Nueva opción Tag Aggregation en reglas de correlación
Se incorpora el nuevo tipo de regla Tag Aggregation en el formulario de Creación y configuración de Reglas de correlación de eventos.
Esta funcionalidad permite definir un patrón de claves de etiquetas mediante el nuevo campo Tag Key Pattern. WOCU-Monitoring identifica todas las etiquetas que coincidan con dicho patrón, agrupa los dispositivos según sus valores y evalúa cada grupo de forma independiente.
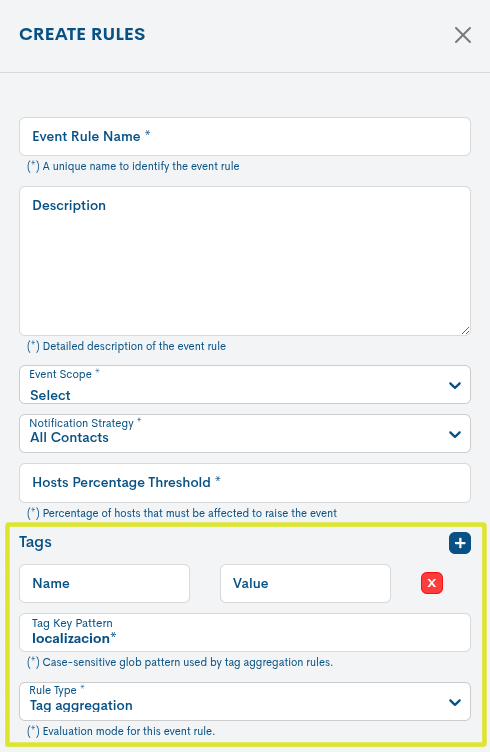
Imagen 5: Configuración de un patrón de agregación en una regla de correlación de eventos.
Por ejemplo, supongamos que los siguientes dispositivos disponen de estas etiquetas:
Dispositivo |
Etiqueta |
Valor |
|---|---|---|
host_1 |
localizacion_0 |
Madrid |
host_2 |
localizacion_1 |
Madrid |
host_3 |
localizacion_0 |
Barcelona |
host_4 |
localizacion_test |
Valencia |
Si en Tag Key Pattern se configura el patrón localizacion*, WOCU-Monitoring localizará
todas las claves que comiencen por localizacion y generará automáticamente tres grupos
de correlación según sus valores:
Madrid: host_1 y host_2.
Barcelona: host_3.
Valencia: host_4.
Aunque los dispositivos utilicen claves diferentes (localizacion_0, localizacion_1 o
localizacion_test), aquellos que compartan un mismo valor quedarán incluidos en el mismo grupo.
A continuación, cada grupo se evalúa de manera independiente según las condiciones configuradas en la regla. Por ejemplo, si se establece un Hosts Percentage Threshold del 50 %, cuando uno de los dos dispositivos del grupo Madrid se encuentre afectado, se alcanzará el 50 % y se generará el correspondiente evento de correlación.
En resumen, esta mejora permite definir reglas más flexibles y reutilizables, adaptadas automáticamente a los valores existentes en las etiquetas y reduciendo la necesidad de crear reglas independientes para cada localización, grupo o categoría concreta.
3. Nueva acción Root Cause Analysis (RCA)
Se incorpora la nueva Acción Root Cause Analysis (RCA) en las tablas de Hosts y Services, diseñada para facilitar el diagnóstico de incidencias mediante el Asistente de IA de WOCU-Monitoring.
Esta funcionalidad realiza un análisis automático de causa raíz, recopilando y correlacionando la información disponible del Host en las distintas fuentes de observabilidad del Reino:
Metrics
Monitoring
Syslogs
Traps
A diferencia de la Acción Ask IA about a problem, orientada al análisis de un problema concreto, Root Cause Analysis cruza información procedente de las distintas fuentes disponibles para identificar posibles relaciones entre los eventos y determinar el origen más probable de la incidencia.
Para ejecutar el análisis, acceda al menú de acciones del Host o Servicio y seleccione Root Cause Analysis.
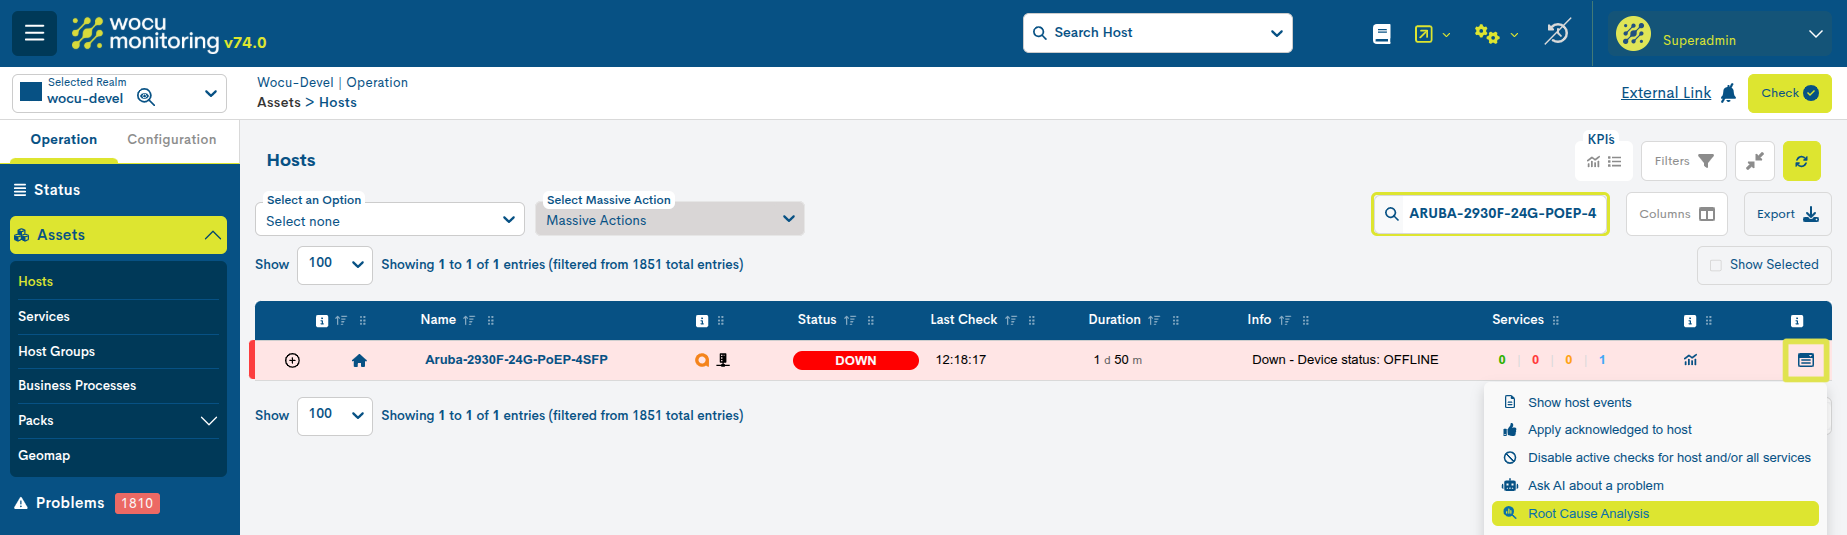
Imagen 6: Acción Root Cause Analysis en un host específico.
Al pulsar sobre la acción se abrirá una ventana de diagnóstico con el resultado del análisis generado por el Asistente de IA.
El informe puede incluir, entre otra información:
Un resumen del problema detectado.
La cronología de los eventos correlacionados.
La posible cadena causal de la incidencia.
Información utilizada para elaborar el diagnóstico.
Acciones o comprobaciones recomendadas para continuar la investigación.
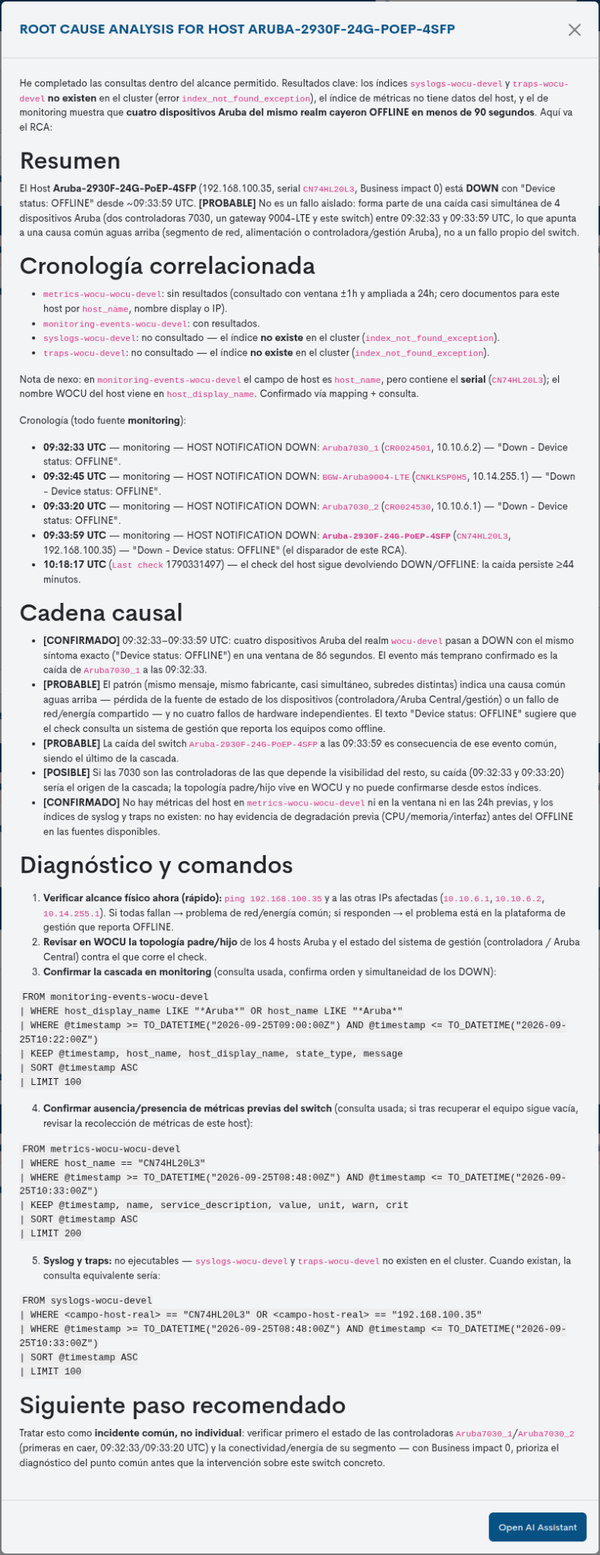
Imagen 7: Respuesta tras la ejecución de la acción Root Cause Analysis sobre un host específico.
El análisis toma siempre el dispositivo en cuestión como nexo principal de correlación. Cuando la acción se ejecuta desde un Servicio, se analizan igualmente los eventos del dispositivo asociado y se prioriza la información relacionada con dicho Servicio cuando esta pueda identificarse en los datos recuperados.
Además, desde la propia ventana de resultados es posible seleccionar Open AI Assistant para continuar el análisis mediante una conversación con el Asistente de IA y realizar preguntas adicionales sobre el diagnóstico obtenido.
Importante
Esta funcionalidad requiere que el Reino disponga de backend Elasticsearch y del módulo de Observability correctamente configurados.
4. Forecast en widgets de métricas y exportación a PDF
Se amplía la funcionalidad Forecast incorporando nuevas opciones de visualización y exportación de información predictiva.
Por un lado, los widgets de tipo Single Metrics Graph incluyen ahora la nueva casilla Enable Forecast dentro de su formulario de configuración. Al habilitarla, el gráfico incorpora la predicción de la evolución futura de la métrica seleccionada, representada de forma diferenciada respecto a los datos históricos. Dado que el modo Forecast trabaja sobre una única serie, su activación limita la selección del widget a una sola serie de datos.
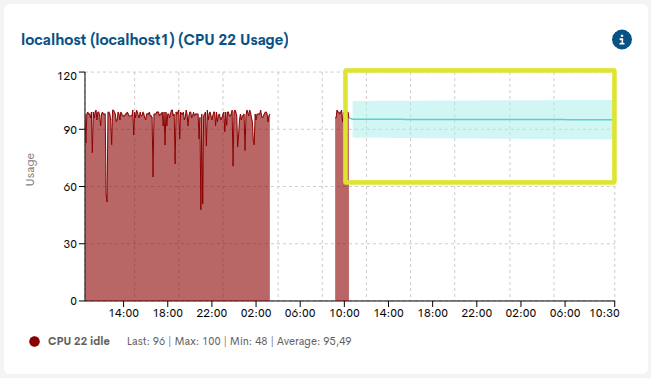
Imagen 8: Visualización del Forecast aplicado a un widget de métricas.
Por otro lado, se mejora la opción de exportación a PDF disponible en la sección Metrics de la Vista detalle de un Dispositivo. Cuando la función de Forecast se encuentre habilitada, la gráfica incluida en el documento exportado mostrará también la estimación futura de la métrica, junto con los datos históricos y el resto de información representada.
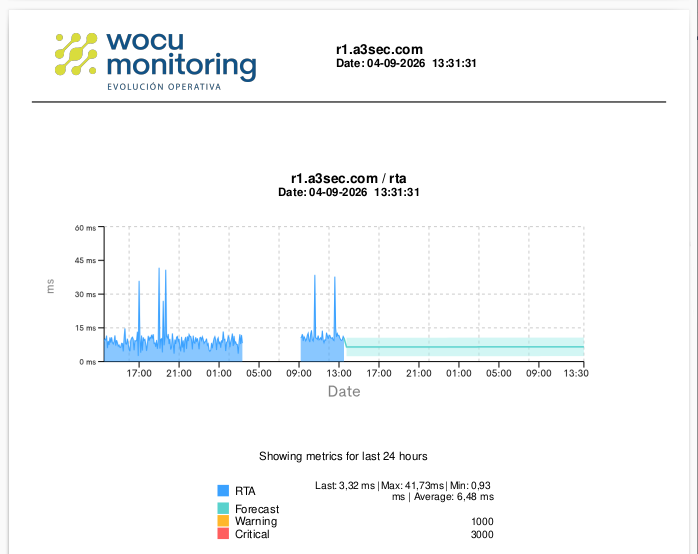
Imagen 9: Exportación a PDF de una gráfica de métricas con Forecast habilitado.
Estas mejoras permiten integrar la capacidad predictiva de Forecast tanto en los dashboards personalizados como en los informes exportados, facilitando el análisis, la anticipación de tendencias y la consulta de la evolución prevista de las métricas monitorizadas.
5. Nuevas integraciones en Anomalías
Nueva vista de Anomalías en Observability
Se incorpora la nueva vista Anomalies dentro del módulo Observability, que centraliza en una única tabla todas las anomalías detectadas en el Reino seleccionado en las últimas 24 horas.
La vista ofrece información detallada de cada anomalía, incluyendo fecha y hora, score, host, servicio, métrica, valor actual, valor típico y nivel de desviación. Esta información permite detectar rápidamente comportamientos fuera de lo habitual, priorizar las anomalías más relevantes según su score, agilizar el análisis de incidencias y disponer de una visión centralizada de las desviaciones detectadas en todo el Reino.
Además, para la gestión de anomalías se incluye:
Filtro por rango temporal, con periodos predefinidos y selección personalizada.
Filtro por Score, para filtrar las anomalías según su nivel de relevancia. La puntuación, comprendida entre 0 y 100, cuantifica el grado en que el valor observado se desvía del comportamiento esperado. Cuanto mayor es el Score, mayor es la significancia de la anomalía.
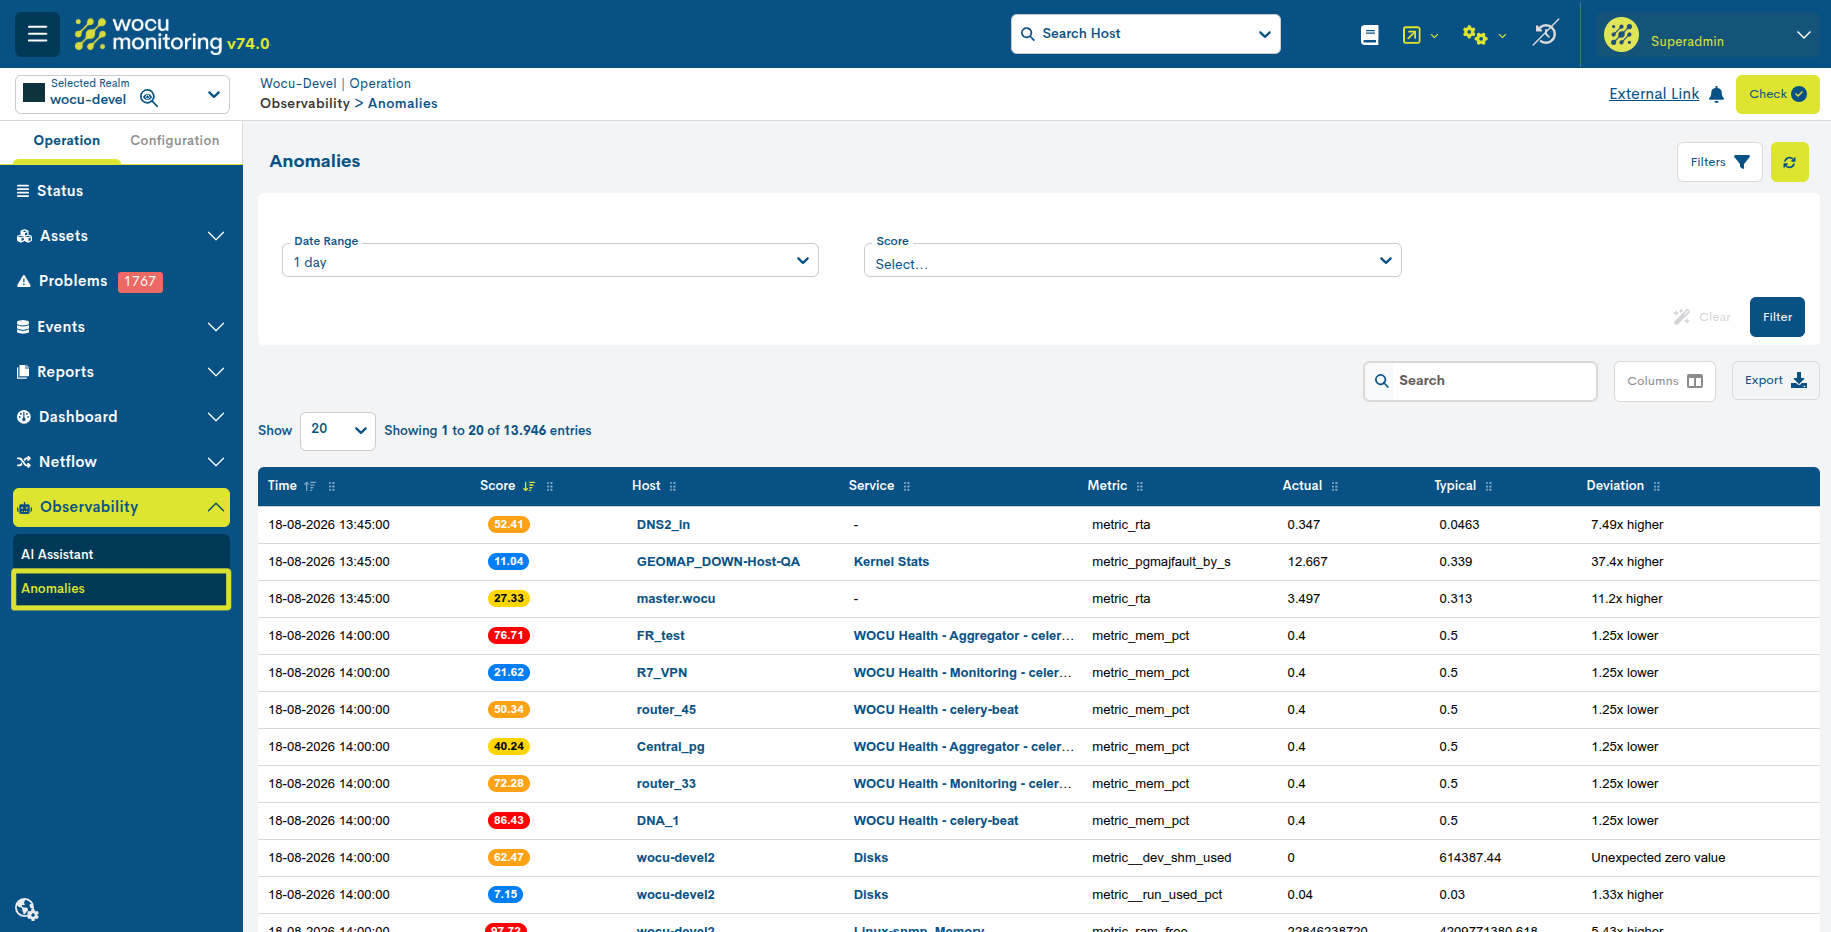
Imagen 10. Vista general de Anomalies en Observability con filtros por rango temporal y Score.
Nueva columna Deviation en la tabla de anomalías
Se incorpora la nueva columna Deviation en la tabla de anomalías a nivel de Dispositivo, ofreciendo un mayor contexto para evaluar rápidamente la magnitud de las desviaciones detectadas y facilitar su análisis operativo.
Este nuevo campo facilita la interpretación de las anomalías detectadas al mostrar de forma directa la diferencia entre el valor real registrado (Actual) y el valor esperado (Typical). Además de indicar la magnitud de la desviación, permite identificar si el valor observado se encuentra por encima o por debajo del comportamiento habitual.
Por ejemplo, un valor como 3.42x higher indica que el valor registrado es aproximadamente 3,42 veces superior al valor esperado.
La nueva columna Deviation complementa la información proporcionada por Score. Mientras que Score expresa la relevancia de la anomalía mediante una puntuación normalizada, Deviation ofrece una referencia más intuitiva sobre cuánto se ha alejado el valor observado de su comportamiento esperado.
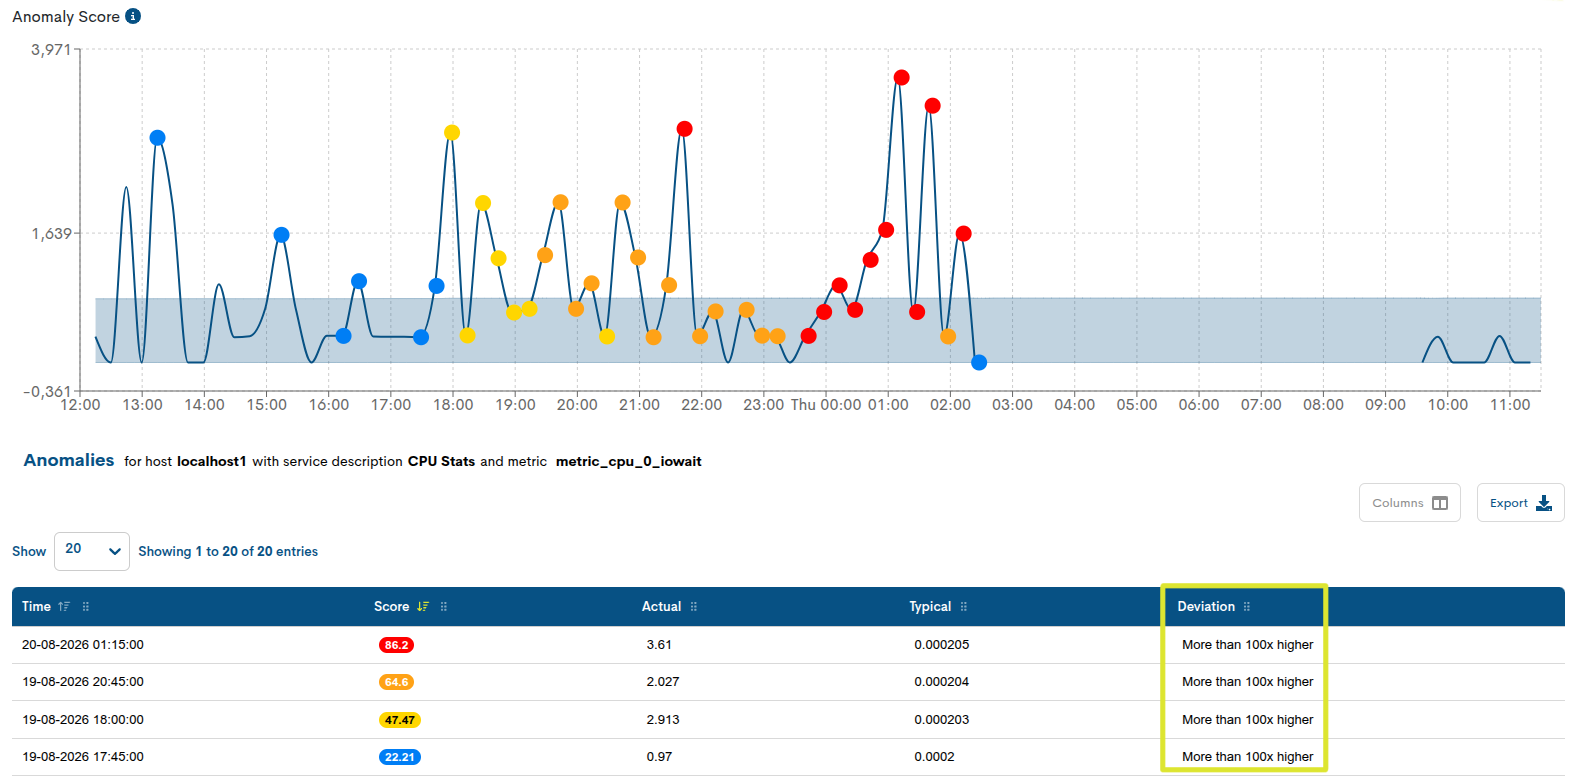
Imagen 11. Vista de anomalías a nivel de Dispositivo con la nueva columna Deviation.
Nuevo filtro Score en la vista de anomalías de Hosts
Se incorpora un nuevo filtro Score en la vista Anomalies de los Hosts, destinado a facilitar la identificación y análisis de las anomalías según su nivel de relevancia.
La puntuación Score, comprendida entre 0 y 100, cuantifica el grado en que el valor observado se desvía del comportamiento esperado. Cuanto mayor es el Score, mayor es la significancia de la anomalía.
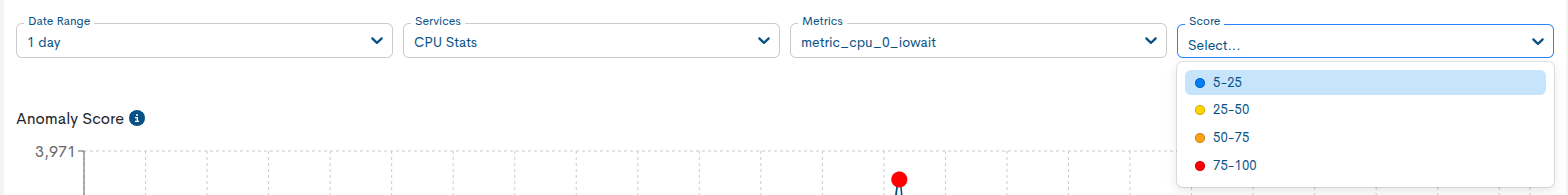
Imagen 12. Vista del filtro Score aplicado al análisis de anomalías de un Host.
Para facilitar el filtrado, los resultados se agrupan en cuatro rangos:
5 - 25: anomalía baja. El valor presenta una desviación leve respecto a lo esperado.
25 - 50: anomalía moderada. La desviación comienza a ser significativa.
50 - 75: anomalía alta. El comportamiento observado se aleja claramente del patrón esperado.
75 - 100: anomalía muy alta. Representa las desviaciones más relevantes o inusuales.
De este modo, el usuario puede acotar los resultados y centrar el análisis en aquellas anomalías que presentan un determinado nivel de significancia dentro del Service, la Metric y el intervalo temporal seleccionados.
Con esta mejora, la vista de anomalías de un Host incorpora mayores capacidades de filtrado, permitiendo localizar y priorizar con mayor rapidez las desviaciones más relevantes.
Vista de anomalías disponible a nivel de Servicio
La vista Anomalies se amplía y pasa a estar disponible también para un Service concreto, permitiendo analizar directamente las anomalías asociadas a sus métricas.
Con esta mejora, el análisis de anomalías queda disponible en los tres niveles principales de WOCU-Monitoring: Realm, Host y Service, facilitando una navegación más precisa desde una visión global hasta el detalle de un servicio específico.
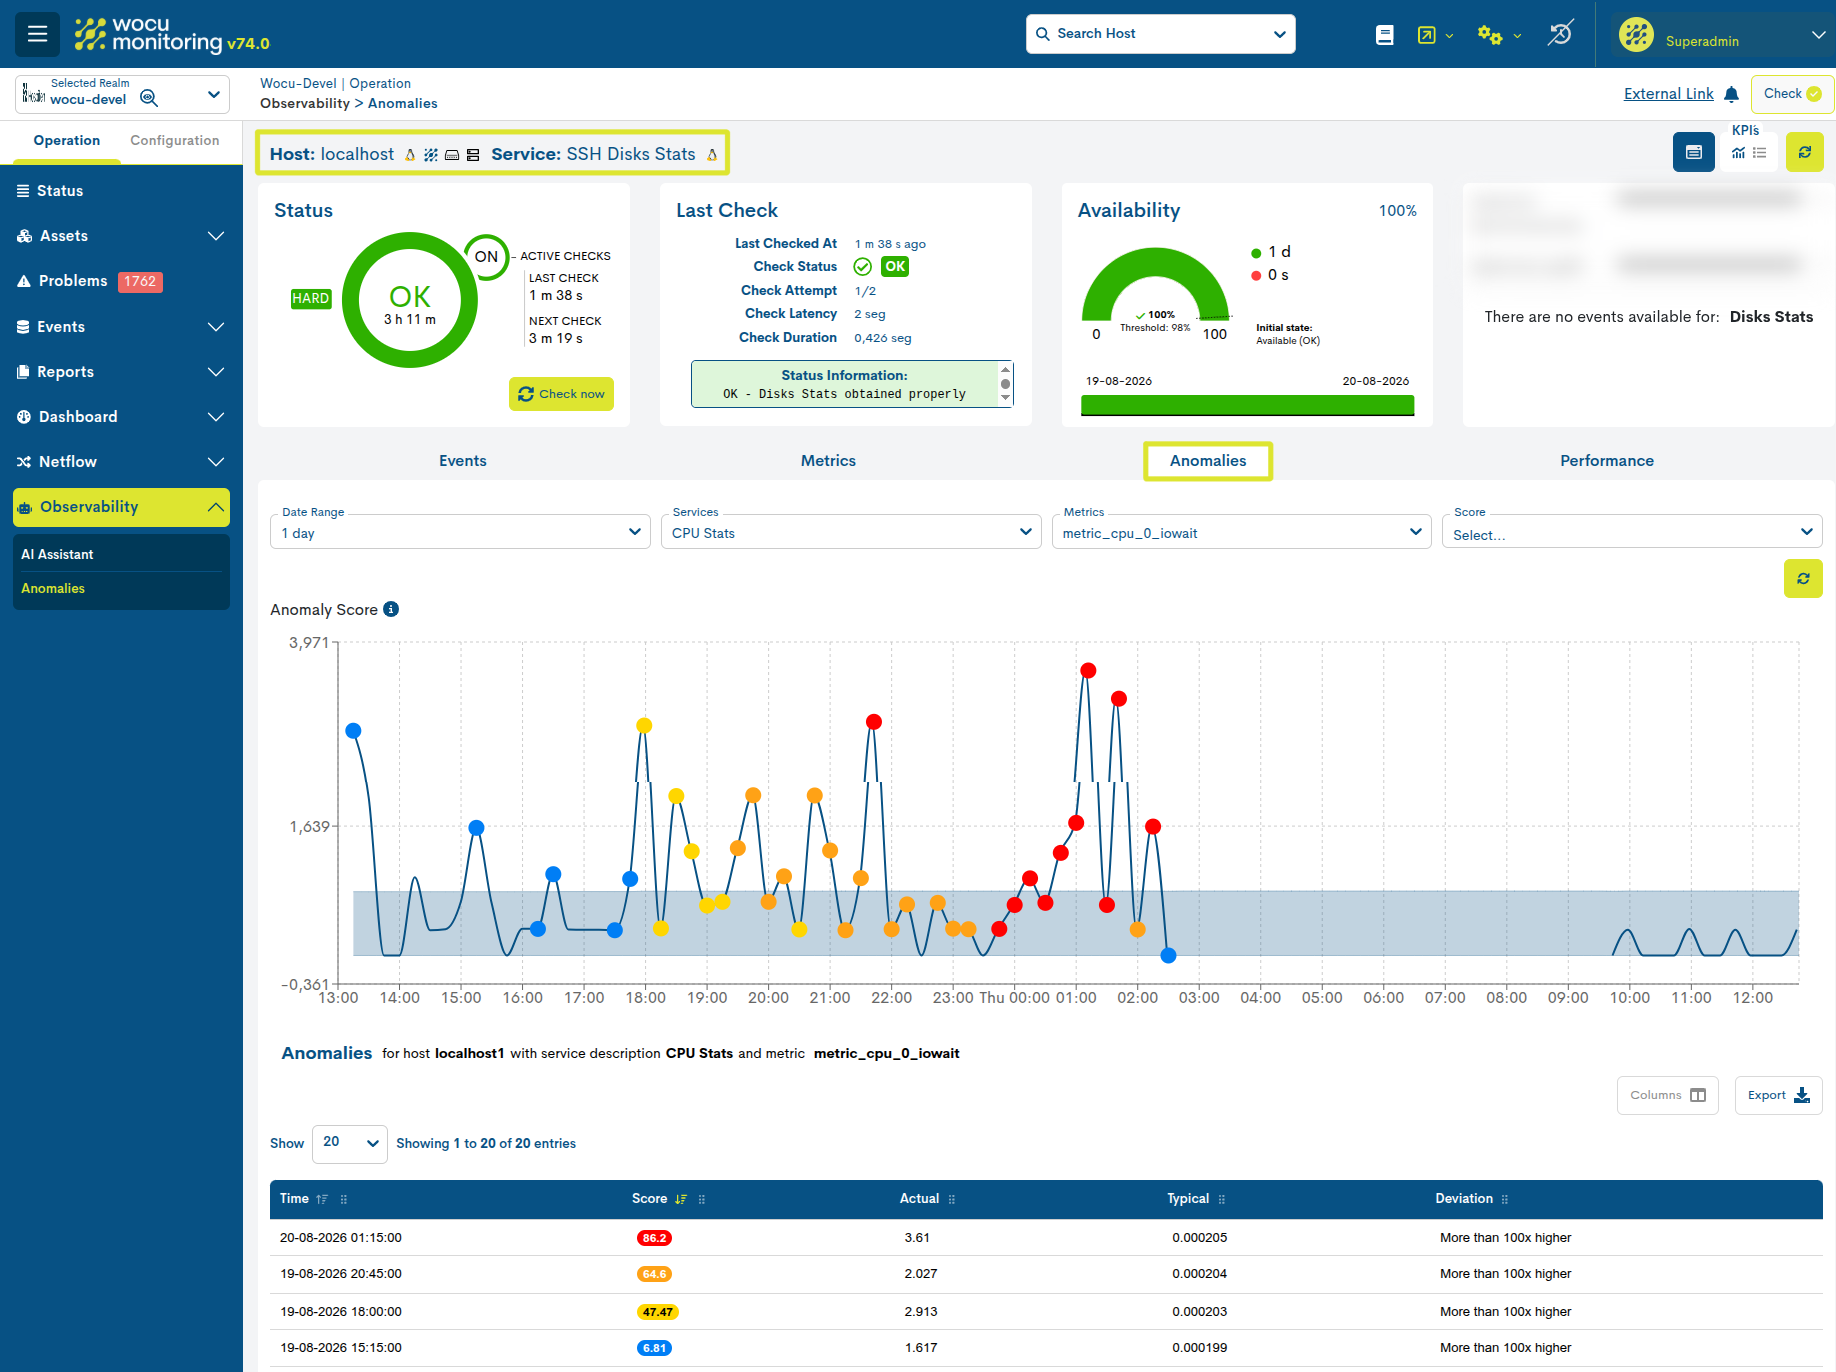
Imagen 13. Vista de anomalías del servicio SSH Disks Stats.
6. Asistente de IA sobre Elastic Agent Builder
Esta versión incorpora importantes mejoras en el IA Assistant de WOCU-Monitoring, tanto en su integración con Elastic como en la gestión y control de su consumo.
Migración del Asistente de IA a Elastic Agent Builder
El IA Assistant de WOCU-Monitoring se migra a la API de Elastic Agent Builder, la nueva experiencia conversacional de Elastic, en sustitución del anterior Observability AI Assistant. Con este cambio, el Asistente conversa sobre el contexto de observabilidad de cada Reino a través de un agente propio, y las conversaciones pasan a gestionarse mediante la API de Agent Builder en lugar de acceder directamente al índice interno de Elastic.
Requisitos mínimos
Esta funcionalidad requiere licencia Enterprise y, como mínimo, Elastic Stack 9.3. En Elastic Stack 9.3, Agent Builder está disponible como funcionalidad preview y debe activarse manualmente. A partir de la versión 9.4 pasa a ser la experiencia predeterminada, mientras que en entornos Serverless se encuentra habilitado por defecto.
La API Key configurada para el Reino debe incluir el privilegio
feature_agentBuilder.all.
El detalle completo de permisos, requisitos de versión y procedimiento para actualizar claves creadas antes de esta migración se encuentra disponible en el apartado Creación de la API Key.
Control y contabilización del consumo del Asistente de IA
Además, esta versión incorpora la contabilidad de consumo del Asistente de IA y su control por Reino:
Medición por Reino y por usuario: se contabilizan los tokens de entrada y salida, el número de llamadas al modelo y las ejecuciones del agente en un registro mensual, mediante una tarea periódica que sincroniza el consumo desde la API de Agent Builder.
Límites de consumo: es posible definir cupos mensuales de tokens por Reino y sub-límites por usuario, así como activar o desactivar el Asistente para usuarios concretos.
Modelo de coste: el consumo se traduce a coste a partir de precios por modelo (entrada y salida) y del coste por ejecución, configurables desde el panel de administración, junto con un cuadro de mando de consumo y coste por Reino.
Estas capacidades permiten ofrecer el Asistente de IA de forma controlada, conociendo en todo momento el consumo de cada Reino y acotándolo cuando sea necesario.
7. Configuración masiva de umbrales dinámicos
WOCU-Monitoring incorpora una nueva opción para habilitar o deshabilitar umbrales dinámicos de forma masiva sobre varios hosts, simplificando su configuración cuando esta funcionalidad debe aplicarse sobre un conjunto amplio de activos.
La configuración masiva está disponible desde: Monitored Assets > Hosts > Massive Configure > Dynamic Thresholds.
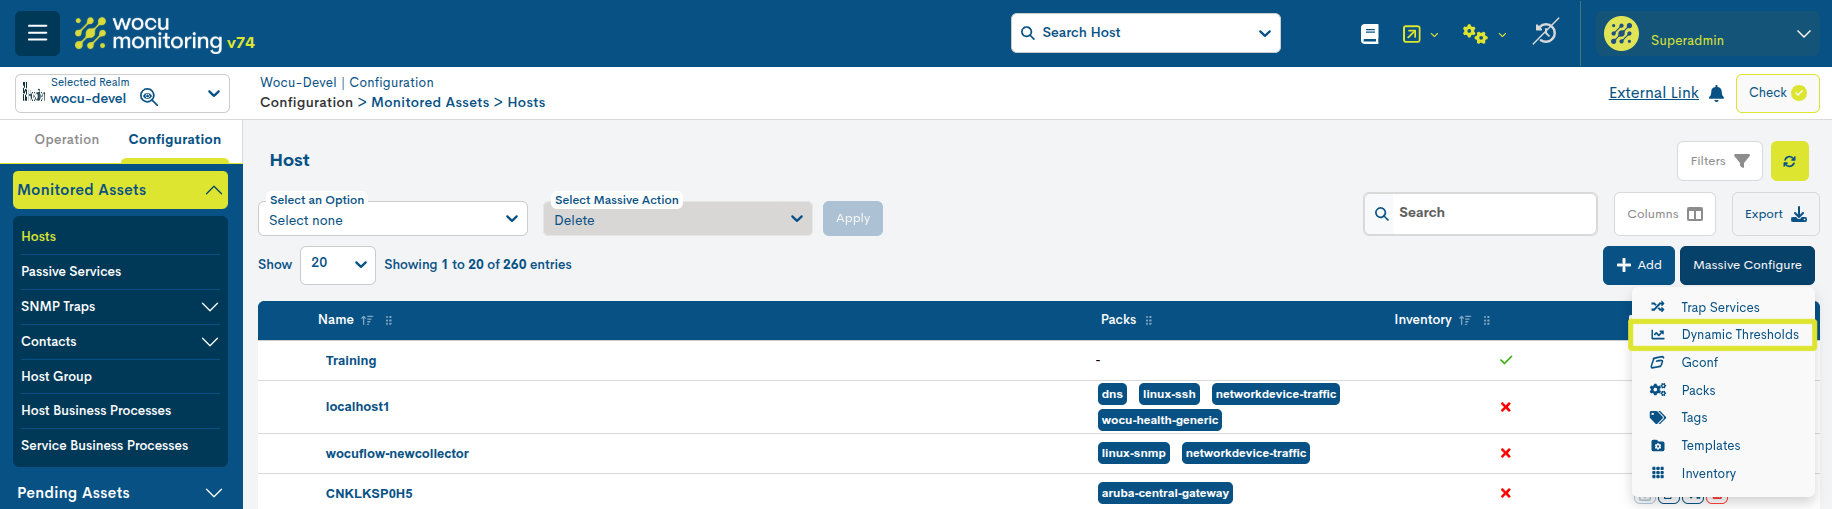
Imagen 14: Acceso a la configuración masiva de umbrales dinámicos desde la vista de Hosts.
Los umbrales dinámicos permiten evaluar determinadas métricas teniendo en cuenta su comportamiento histórico y el rango de valores esperado, facilitando la detección de desviaciones o comportamientos anómalos que podrían no ser identificados mediante umbrales estáticos.
Al acceder a esta opción se muestra una ventana con los siguientes campos:
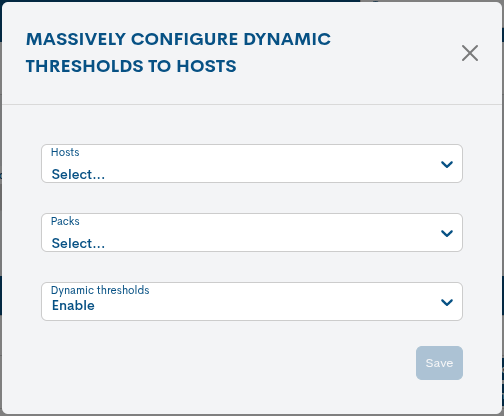
Imagen 15: Ventana de configuración masiva de umbrales dinámicos para Hosts.
Hosts: permite seleccionar los hosts sobre los que se aplicará la configuración.
Packs: muestra los packs compatibles con la funcionalidad de umbrales dinámicos.
Dynamic thresholds: permite seleccionar Enable o Disable para habilitar o deshabilitar esta funcionalidad sobre la selección realizada.
Esta nueva opción facilita la administración de entornos con un elevado número de dispositivos, al permitir aplicar la configuración de forma masiva y evitar modificaciones manuales dispositivo por dispositivo.
Por ejemplo, es posible seleccionar varios dispositivos que utilicen el pack
networkdevice-cpu y habilitar los umbrales dinámicos para todos ellos en una única operación.
8. Nuevos canales de notificación: SMS y Microsoft Teams
WOCU-Monitoring amplía sus mecanismos de notificación con la incorporación de dos nuevos canales de comunicación: SMS y Microsoft Teams.
Estas nuevas integraciones permiten distribuir los avisos asociados al estado y a los eventos de los activos monitorizados a través de diferentes medios, adaptándose a las necesidades operativas de cada entorno.
Por un lado, el envío mediante SMS permite recibir notificaciones directamente en dispositivos móviles, facilitando el acceso inmediato a información relevante sobre incidencias o cambios de estado. Por otro, la integración con Microsoft Teams posibilita centralizar estos avisos en los canales de trabajo habituales de los equipos mediante Webhook.
Con esta ampliación, WOCU-Monitoring ofrece mayor flexibilidad en la configuración de las notificaciones, complementando los canales ya disponibles y favoreciendo una comunicación más ágil ante eventos detectados por la plataforma.
Véase el siguiente ejemplo de notificaciones en ambos medios:
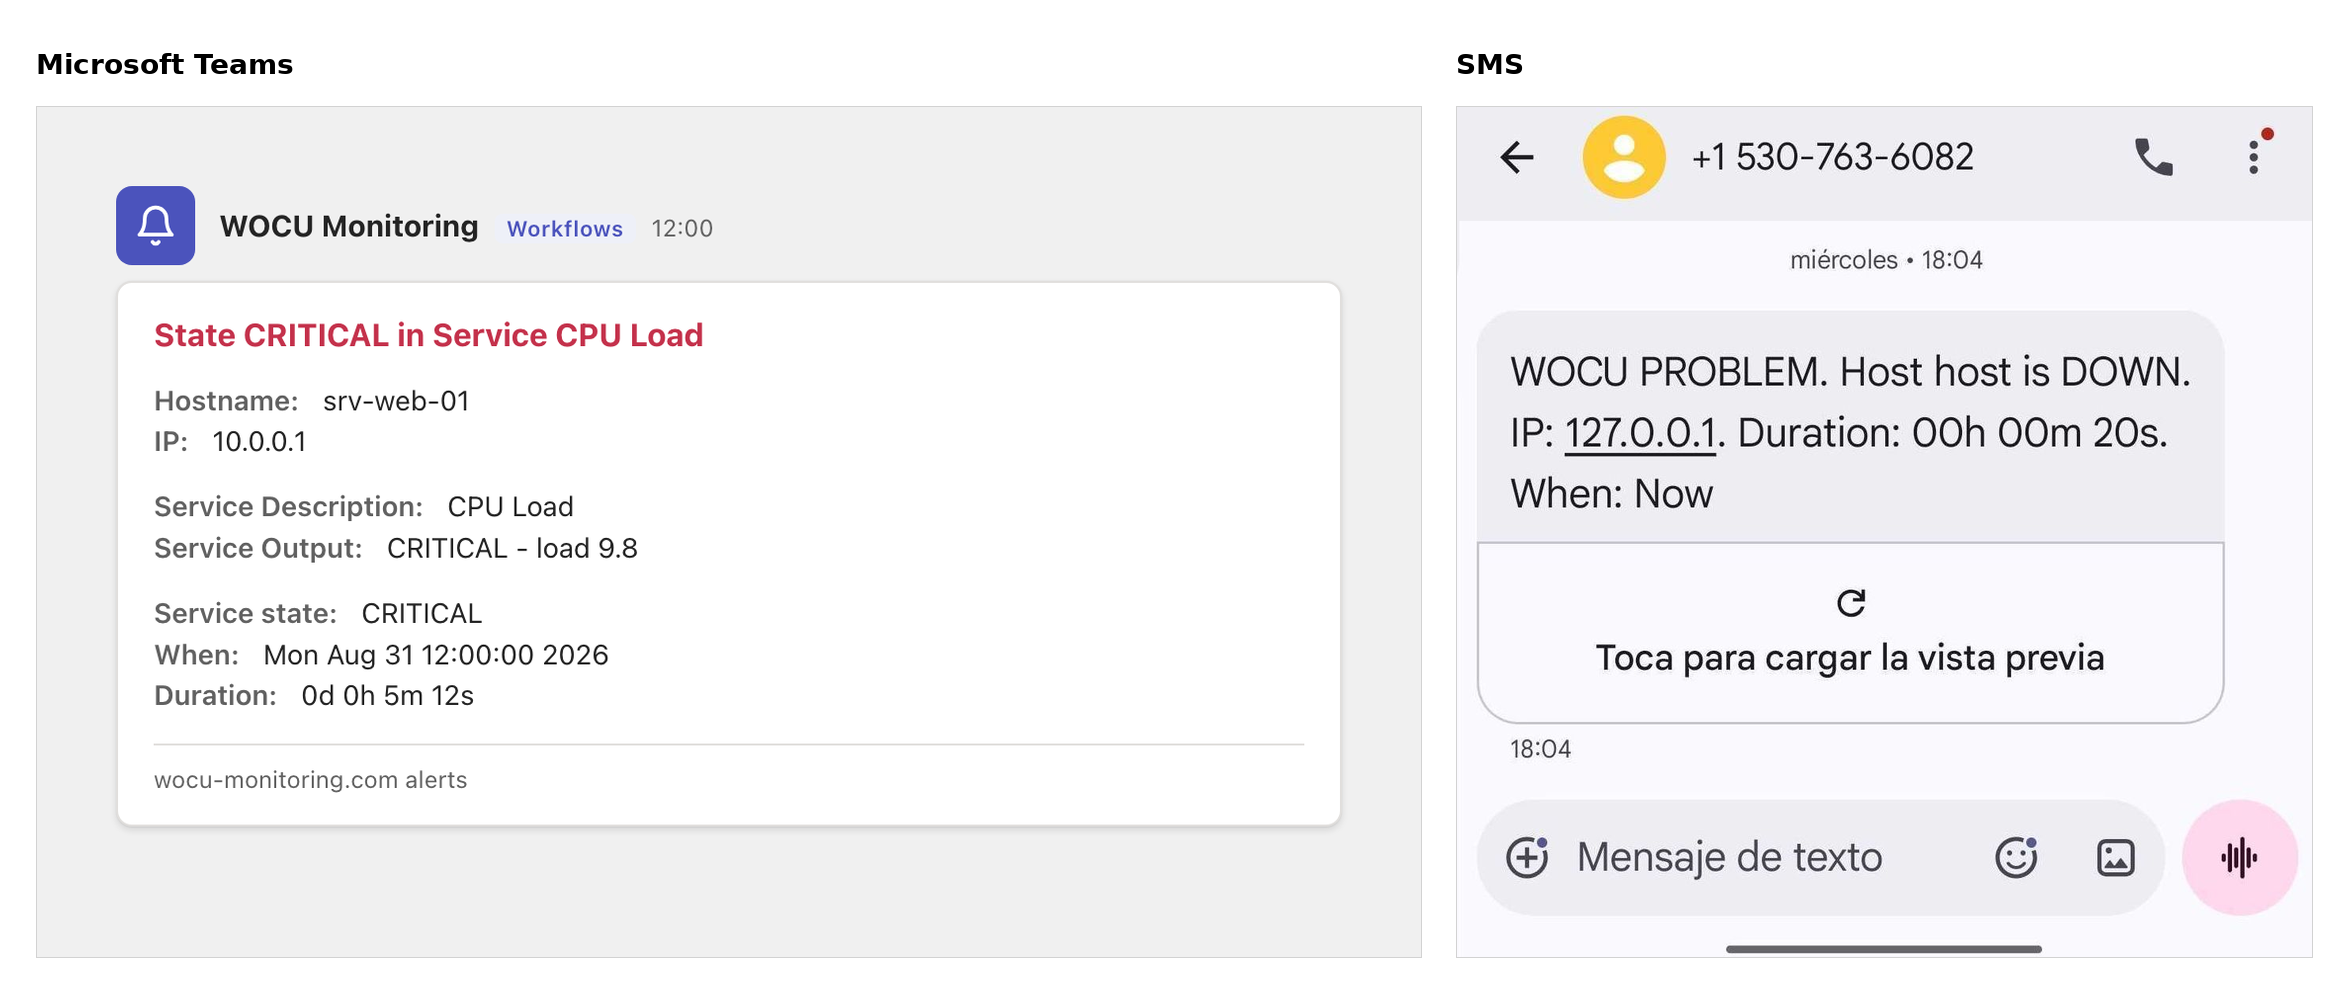
Imagen 16: Ejemplo de notificaciones enviadas mediante Microsoft Teams y SMS.
Más información en: Añadir Comando (Add Command).
9. Nuevo widget Host Groups by state
Se incorpora el nuevo widget Host Groups by state en la vista Estado (Status). Este nuevo componente ofrece una visión gráfica del estado de los Host Groups mediante un código de colores según el porcentaje de Hosts en estado Down o Unreach.
Cada hexágono representa un Host Group y permite consultar, mediante tooltip, su nombre y distribución de estados. Al hacer clic, se accede directamente a la vista detalle del Host Group.
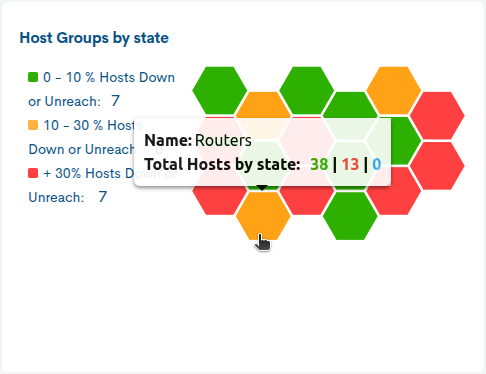
Imagen 17: Visualización del estado de los Host Groups mediante el widget Host Groups by state.
Esta nueva visualización agiliza la detección de grupos degradados y simplifica la supervisión de infraestructuras con un elevado número de Hosts y Host Groups.
10. Nueva acción de duplicado de widgets
Se incorpora una nueva acción para Duplicar widgets de forma individual desde el Modo Edición del dashboard (Estado (Status)). A partir de esta versión, cada widget incluye una opción específica de duplicado que permite generar una copia del elemento seleccionado, conservando su configuración actual.
Esta funcionalidad facilita la creación de dashboards, ya que permite reutilizar widgets existentes como punto de partida para nuevas visualizaciones, evitando tener que configurarlos manualmente desde cero. Una vez duplicado, el nuevo widget podrá editarse de forma independiente para ajustar sus parámetros, contenido o presentación según las necesidades del usuario.
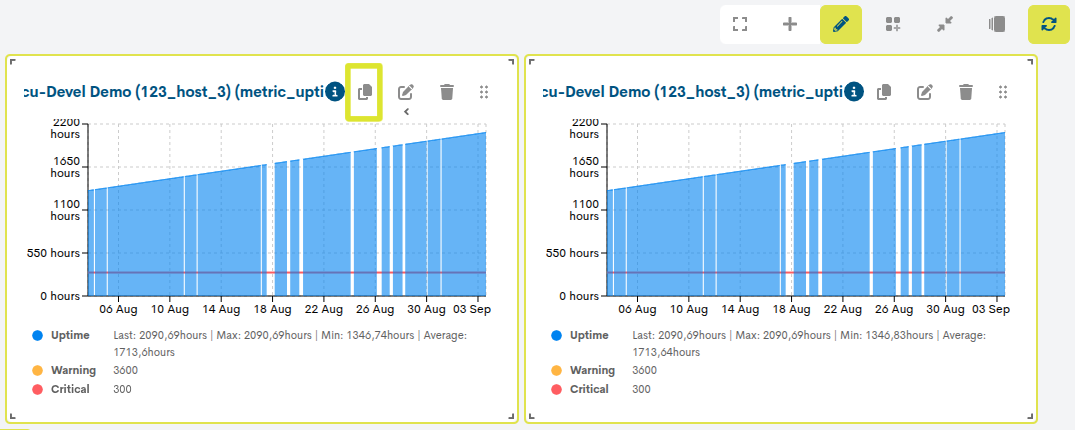
Imagen 18: Duplicado individual de un widget desde el Modo Edición del dashboard.
11. Nuevos selectores de Hosts y Servicios en la vistas detalle
Se incorporan nuevos selectores de navegación en las vistas de detalle de Hosts y Servicios, facilitando el acceso entre los distintos elementos monitorizados (dispositivos y servicios) dentro de un mismo Reino.
En la vista de detalle de un Host, el selector muestra todos los dispositivos pertenecientes al Reino actual, permitiendo acceder directamente al detalle del elemento seleccionado. Del mismo modo, en la vista de detalle de un Servicio, se añade un selector con los Servicios de monitorización disponibles para el dispositivo actual, agilizando la navegación entre ellos.
Además, cada elemento de ambos selectores incorpora un indicador visual mediante un punto de color, que representa su estado actual de monitorización y permite identificarlo rápidamente antes de acceder a su detalle.
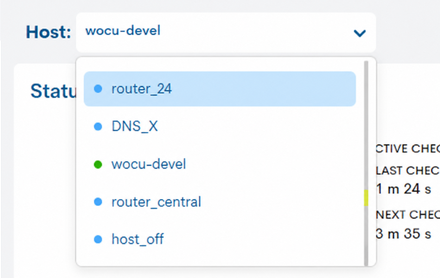
Imagen 19. Selector de Hosts en la vista detalle del host «wocu-devel».
12. Packs de Monitorización
Nuevo pack de monitorización Elasticsearch ML
Se incorpora el nuevo pack Elasticsearch ML, orientado a supervisar el estado operativo de los jobs de Machine Learning asociados a cada Reino en Elasticsearch.
Este pack de monitorización agrupa en un único servicio la información relevante del job y su datafeed, incluyendo su estado, memoria, límites, fechas de procesado y estadísticas de ejecución. Además, permite identificar de forma clara situaciones anómalas mediante los estados de disponibilidad OK, WARNING, CRITICAL y UNKNOWN, facilitando la detección de jobs detenidos, con errores, sin datos recientes o con problemas de acceso o configuración.
Optimización del rendimiento y consumo de CPU en los Packs
Se ha llevado a cabo una optimización general del consumo de CPU asociado a la ejecución de los chequeos incluidos en los Packs de WOCU-Monitoring.
Esta mejora se apoya en tres líneas principales:
Separación de dependencias ligeras y pesadas, de forma que las dependencias con mayor coste computacional únicamente se cargan cuando son estrictamente necesarias.
Carga diferida del entorno y de las dependencias SNMP, evitando inicializarlas desde el wrapper del chequeo del fabricante cuando el propio chequeo no las requiere.
Ejecución optimizada de chequeos por fabricante, permitiendo que aquellos compatibles se ejecuten dentro del mismo proceso que el wrapper, evitando la creación de procesos adicionales.
En conjunto, estos cambios permiten reducir el consumo de recursos y mejorar el rendimiento y los tiempos de respuesta de la plataforma, especialmente en entornos con un elevado número de chequeos ejecutándose de forma concurrente.
Nuevo mecanismo Load_throttle para la gestión adaptativa de chequeos
Se incorpora una mejora en el procedimiento de polling de chequeos entre los Pollers y el Scheduler, con el objetivo de adaptar dinámicamente la carga de trabajo de cada Poller a su capacidad real de procesamiento.
La nueva funcionalidad, denominada load_throttle, introduce parámetros de configuración
que permiten ajustar el número máximo de chequeos solicitados al Scheduler en función
del uso actual de CPU del propio Poller.
De este modo, cuando un Poller presenta una carga elevada de CPU, deja de solicitar el máximo teórico de chequeos que podría procesar y reduce automáticamente el volumen de trabajo solicitado de acuerdo con los umbrales configurados.
Esta mejora permite evitar situaciones de sobrecarga, distribuir de forma más eficiente el trabajo de monitorización y mantener un comportamiento más estable del sistema en escenarios de alta demanda.
13. Nuevas funcionalidades de observabilidad
Nueva vista Home
Se incorpora una nueva vista Home en el apartado Status, dirigida a los clientes de observabilidad. Esta página reúne en un único panel la información más relevante sobre el estado de la infraestructura y facilita el acceso al detalle de cada grupo de hosts.
La vista Home incluye cuatro nuevos widgets:
Estado de los hosts (Hosts Status): muestra el número total de hosts y su distribución por estado: Up, Down, Unreach y Filtered.
Estado de los servicios (Services Status): resume los servicios según su estado: OK, Critical, Warning, Unknown y Filtered.
Geomap: representa en el mapa la ubicación de los hosts. Incluye filtros por estado y por grupo de hosts para acotar la información mostrada.
Grupos de hosts por estado (Host Groups by state): presenta los grupos en forma de panel y utiliza colores para indicar el porcentaje de hosts caídos o inaccesibles.
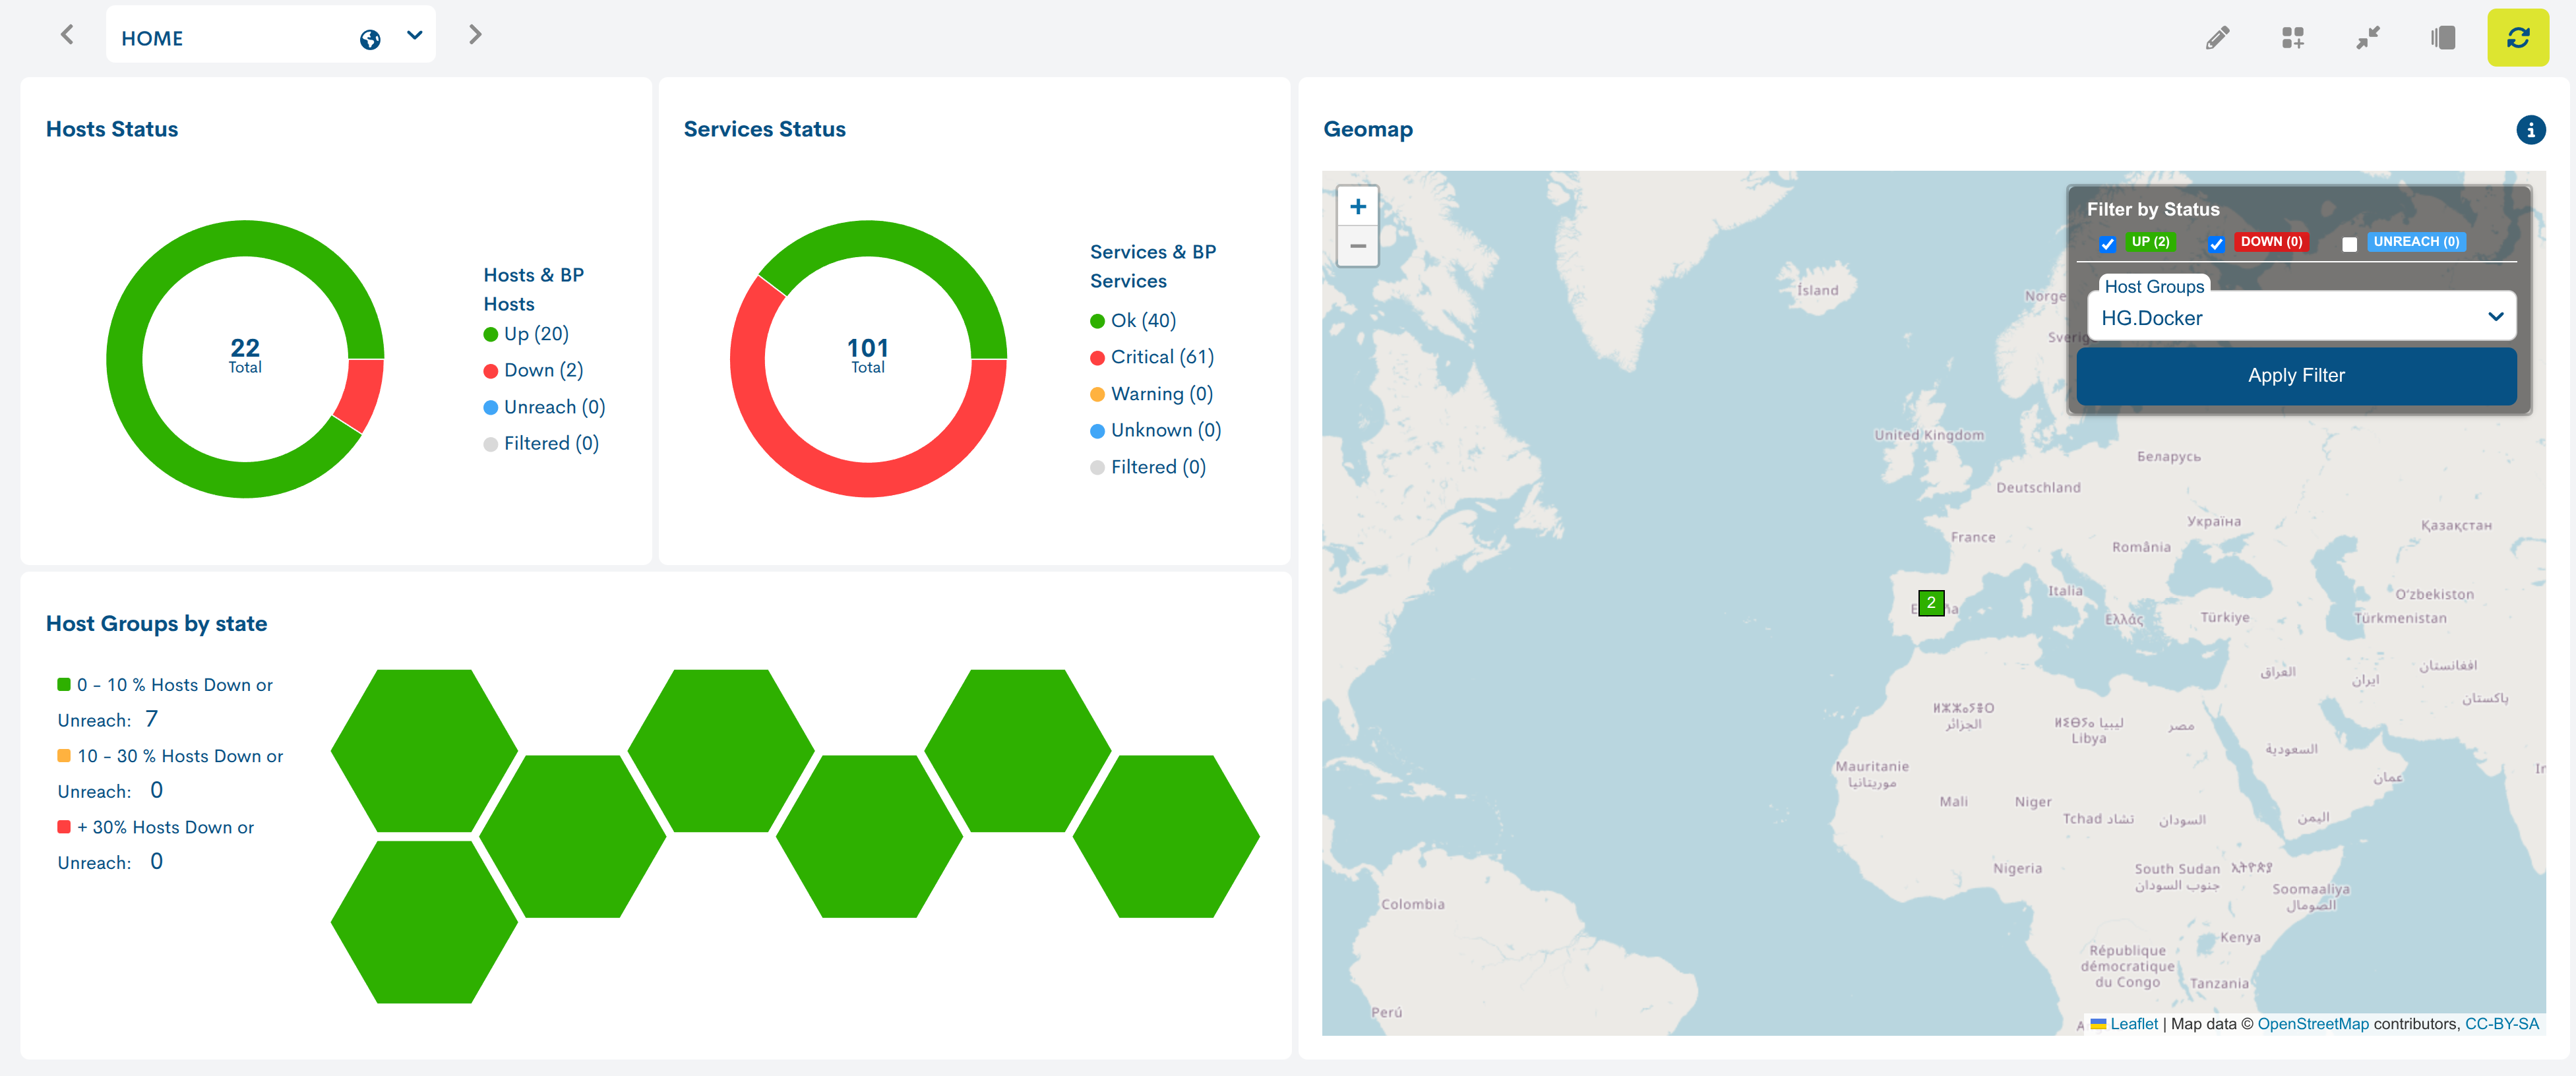
Imagen 20. Vista Home con los widgets de estado de hosts, estado de servicios, geomapa y grupos de hosts por estado
Acceso al resumen de un grupo de hosts
El widget Grupos de hosts por estado incorpora un enlace a los grupos de hosts (sedes). Al seleccionar uno de los hexágonos del panel, se abre la página de resumen del grupo correspondiente.
El resumen del grupo de hosts incorpora las siguientes mejoras:
filtro por estado de los hosts;
selector desplegable de host para consultar sus servicios;
widget Tráfico de red (Network Traffic); y
widget Previsión del tráfico de red (Network Traffic Forecast).
Los widgets de tráfico muestran los siguientes indicadores para un periodo de 24 horas:
promedio de tráfico entrante (In avg);
promedio de tráfico saliente (Out avg);
promedio de tráfico total (Total avg); y
pico de tráfico (Peak).
El widget Previsión del tráfico de red ofrece los mismos indicadores como estimación para las próximas 24 horas, lo que permite anticipar posibles incrementos de carga y facilitar la planificación de la capacidad.
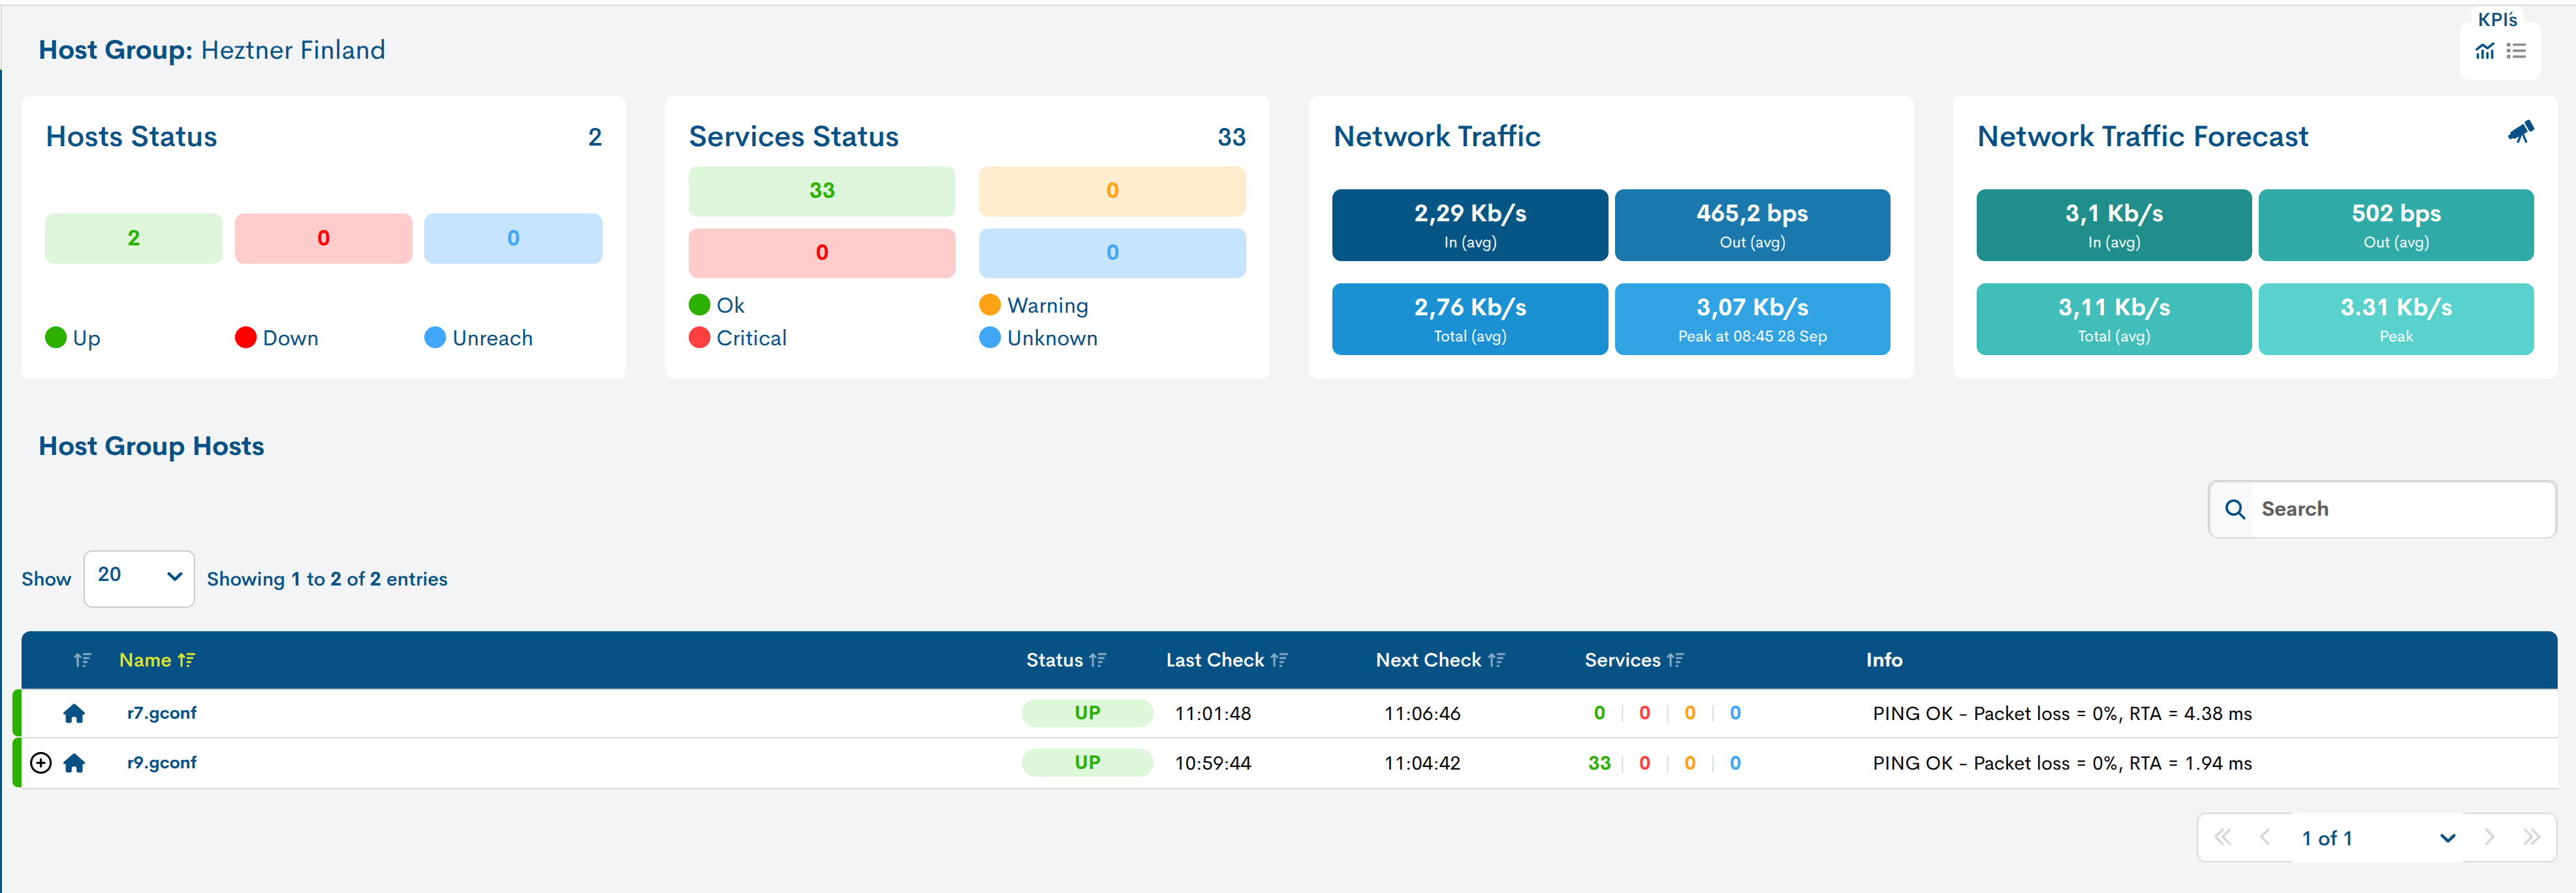
Imagen 21. Resumen de un grupo de hosts con estado, servicios, tráfico de red y previsión de tráfico
14. Nueva métrica de Ingress data para el control de ingesta en Observabilidad
WOCU-Monitoring incorpora una nueva funcionalidad de medición del volumen de datos enviados a la plataforma de Observabilidad (Elastic).
La información se registra por Reino y por Espacio, permitiendo conocer tanto el consumo diario como el volumen acumulado durante el mes en curso. De este modo, los administradores pueden identificar fácilmente qué entornos generan más datos, analizar su evolución y detectar incrementos anómalos de consumo.
La medición contempla los principales flujos de datos de observabilidad:
Métricas: series temporales asociadas al rendimiento de Hosts y servicios.
Eventos de monitorización: cambios de estado, alertas y notificaciones.
Syslog: registros enviados por los dispositivos a la plataforma.
La información está disponible desde el panel de administración, dentro del bloque Ingest metering, donde es posible consultar el consumo por Reino y por Espacio, la cuota asignada, el porcentaje utilizado, el volumen restante y posibles excesos de cuota. También se incorpora un histórico diario, acompañado de una gráfica con la evolución del consumo de los últimos 30 días.
Esta nueva capacidad aporta mayor visibilidad y transparencia sobre el uso real de la plataforma, facilita la detección temprana de incrementos inesperados de ingesta y proporciona una base objetiva para dimensionar los recursos y establecer modelos de consumo asociados al volumen de datos.
La medición se realiza automáticamente una vez al día y contabiliza el volumen de datos enviados por el cliente, independientemente de cómo Elasticsearch los comprima o almacene internamente. Los Reinos con un backend de Elasticsearch configurado quedan incluidos automáticamente, sin requerir ninguna configuración adicional por parte del usuario.
15. Nueva gestión de cuotas mensuales de ingesta por Reino y Espacio
WOCU-Monitoring incorpora una nueva funcionalidad para la gestión de cuotas mensuales de ingesta, permitiendo definir el volumen máximo de datos contratado para cada Reino y cada Espacio.
Al crear estos elementos, la plataforma asigna una cuota por defecto que posteriormente puede ser ajustada por el administrador según las condiciones establecidas para cada cliente. De este modo, el volumen contratado queda reflejado directamente en WOCU-Monitoring y puede compararse con el consumo real registrado durante el mes en curso.
La gestión se realiza desde el panel de administración, donde es posible consultar y modificar las cuotas asignadas. Para cada Reino y Espacio se muestra información como el consumo acumulado, la cuota disponible, el porcentaje utilizado, el volumen restante y el estado respecto al límite configurado.
En el caso de los Espacios, la cuota se evalúa sobre el consumo agregado de todos los Reinos que lo componen, lo que permite gestionar una bolsa global de capacidad para entornos con varias sedes, instalaciones o clientes asociados.
Esta funcionalidad facilita el seguimiento de posibles excesos de consumo y proporciona una referencia clara para revisar la capacidad contratada o ajustar la configuración de los entornos que generen un volumen superior al previsto.
Por defecto, los valores de cuota son configurables a nivel de instalación, con una referencia inicial de 1 TB al mes por Reino y 10 TB al mes por Espacio. En esta versión, el sistema informa y registra los excesos de cuota, pero no aplica restricciones automáticas sobre la ingesta.
16. Nuevos endpoints para la monitorizacion de Métricas y Eventos
Endpoint para listar métricas disponibles
Este endpoint retorna las métricas existentes para un reino concreto (como uso de CPU, latencia o tráfico de red) y permite acotar la búsqueda especificando un dispositivo o un servicio determinado.
Es el punto de partida ideal si no se conocen de antemano los nombres exactos de las métricas que se desean consultar posteriormente.
GET /api/metrics/realm/<realm_name>/measurements/
Ejemplo de peticion:
curl -H "Authorization: Token abc123" \
  "https://<dominio>/api/metrics/realm/<realm_name>/measurements/?host=srv-web01"
Ejemplo de respuesta:
["cpu_usage_user", "disk_free", "network_in", "network_out", "memory_used"]
Endpoint para consultar los valores de una métrica
Este endpoint devuelve los datos reales (los puntos de la serie temporal) de una o varias métricas para un reino, dispositivo o servicio determinado dentro de una ventana de tiempo concreta.
GET /api/metrics/realm/<realm_name>/data/
Detalles para facilitar su uso:
Formatos de fecha legibles: Puede indicar las fechas en un formato estándar (por ejemplo,
24/07/2026o24/07/2026 14:30:00), sin necesidad de usar timestamps.Rango por defecto: Si no especifica ninguna fecha, se mostrará automáticamente la información de la última hora.
Límite de rango: El rango máximo permitido por consulta es de 7 días.
Autodescubrimiento de métricas: Si omite las métricas en la consulta, el sistema las detectará automáticamente (con un límite en la cantidad de resultados devueltos).
Control de resultados: Puede limitar y ordenar el número de resultados recibidos según sus necesidades.
Ejemplo de petición:
curl -H "Authorization: Token abc123" \
  "https:///<dominio>/api/metrics/realm/<realm_name>/data/?host=srv-web01&measurements=cpu_usage_user,disk_free&time_from=24/07/2026%2000:00:00&time_to=24/07/2026%2023:59:00"
Ejemplo de respuesta:
{
  "data": [
    {
      "metric": "cpu_usage_user",
      "data": [
        { "time": "2026-07-24T10:00:00Z", "host_name": "srv-web01", "value": 42.1, "min": 38.0, "max": 55.3, "unit": "%" },
        { "time": "2026-07-24T11:00:00Z", "host_name": "srv-web01", "value": 39.7, "min": 35.2, "max": 48.9, "unit": "%" }
      ]
    }
  ],
  "total_count": 1
}
Endpoint para la consulta de la monitorización de eventos
Permite consultar el histórico de eventos de un Reino, como caídas y recuperaciones de dispositivos y servicios, notificaciones enviadas, cambios de estado, eventos de flapping o comandos externos. Permite aplicar múltiples filtros (por host, tipo de evento, texto del mensaje o estado) y acotar la búsqueda por rango de fechas, con el mismo funcionamiento que el endpoint de métricas.
GET /api/events/realms/<realm_name>/events/
Ejemplo de petición:
curl -H "Authorization: Token abc123" \
  "https:///<dominio>/api/events/realms/<realm_name>/events/?host=srv-web01&state_type=HARD&size=20"
Ejemplo de respuesta:
  {
  "data": [
    {
      "time": 1753349400,
      "host_name": "srv-web01",
      "type": "HOST ALERT",
      "state": 1,
      "state_type": "HARD",
      "message": "PING CRITICAL - Packet loss = 100%"
    }
  ],
  "total_count": 1
}
Endpoint para consultar eventos de syslog
Permite buscar directamente en los registros de syslog de un Reino, filtrando por dispositivo, severidad, mensaje, tipo de evento o identificador.
GET /api/events/realms/<realm_name>/events/syslogs/
Ejemplo de petición:
curl -H "Authorization: Token abc123" \
  "https:///<dominio>/api/events/realms/<realm_name>/events/syslogs/?host=srv-web01&severity=err"
Ejemplo de respuesta:
  {
  "data": [
    { "@timestamp": "2026-07-24T09:12:33Z", "host": "srv-web01", "severity": "err", "message": "disk quota exceeded" }
  ],
  "total_count": 1
}
Nota
Si el realm_name corresponde a un Multireino, este endpoint consulta automáticamente
el syslog de todos los reinos que lo componen y devuelve los resultados combinados.
Otras mejoras y arreglos
Toda nueva versión está llena de pequeños cambios, arreglos y optimizaciones que cabe destacar brevemente. Pasamos a listar los más notables de esta versión:
Se incorpora una nueva opción de configuración en el Módulo de Seguridad que permite deshabilitar el CAPTCHA integrado en la pantalla de inicio de sesión. La desactivación del CAPTCHA afecta únicamente a este mecanismo de validación y no modifica el resto de controles de seguridad incorporados en el Módulo de Seguridad. La activación o desactivación del CAPTCHA no está disponible desde la interfaz de usuario. Su configuración se gestiona mediante variables internas de settings. En caso de requerir este cambio, deberá solicitarse al equipo técnico correspondiente.
La vista de detalle de un Host Group incorpora ahora la posibilidad de desplegar los Servicios de monitorización asociados a cada Host miembro, facilitando la consulta de su estado e información operativa directamente desde el grupo.
Los campos de configuración del Geomap se han trasladado a la vista final del widget, donde ahora funcionan como filtros interactivos por estado y Host Group. Esto permite ajustar la información mostrada directamente sobre el mapa, sin acceder al modo de edición.
A partir de esta versión, las categorías de Reinos se mostrarán en la interfaz siguiendo el mismo orden definido durante su configuración, respetando así la disposición establecida por el usuario.
Se añade el campo
host display nameen el fichero de exportación en los formatos CSV y JSON en la tabla Events Monitoring.Se mejora la representación gráfica de las Metrics para facilitar la identificación de valores aislados entre intervalos sin datos. A partir de esta versión, cuando un valor de una métrica se encuentra precedido y seguido por valores null, este se mostrará mediante un punto visible en la gráfica. De este modo, los valores aislados podrán identificarse directamente sin necesidad de situar el cursor sobre la gráfica para detectarlos.
Se corrige el comportamiento del panel de filtros de Geomapa (Geomap), evitando que se cierre de forma accidental al desplazar el cursor fuera de él. Ahora se aplica un breve retardo antes del cierre, permitiendo una interacción más estable y fluida.
Se corrige un problema de visualización en el Inventario de Servicios (Services Inventory) que provocaba el descuadre de las columnas al añadir nuevos campos a la tabla. Ahora la información se presenta correctamente alineada.
Se corrige un error en la tabla de Alarmas (Problems) que impedía mantener oculta la columna Business Impact. A partir de esta versión, cuando se oculte dicha columna, la configuración se conserva correctamente tras refrescar la tabla.
Se incorpora un nuevo botón + junto al campo Logger Server en el formulario de Creación de Reinos, permitiendo crear un nuevo servidor de logging directamente desde este punto, sin necesidad de acceder previamente a Logger Resources.
Se corrige un error que podía provocar el fallo de la exportación de Informes de Multimétricas (Multimetrics) a formato XLSX cuando alguna métrica no incluía el campo time. A partir de esta versión, estos casos se gestionan correctamente, evitando la generación de archivos inválidos.
Se corrige un problema en las tablas de Eventos de Monitorización (Monitoring) que podía provocar que se mostrara el
host_nameen lugar delDisplay Nameconfigurado.Se corrige un problema visual en la tarjeta Credits Penalties que provocaba que las barras de progreso se mostraran siempre en color gris, incluso cuando existían datos. Además, se ajusta el ancho del texto asociado al activo afectado para que ocupe correctamente todo el espacio disponible.
A partir de esta versión, determinadas macros solo estarán disponibles cuando el módulo de Observability se encuentre habilitado, evitando mostrar opciones que no son aplicables en entornos donde esta funcionalidad no está activa.
Se mejora el funcionamiento de Ask AI en Servicios, corrigiendo los casos en los que las peticiones podían finalizar sin resultados visibles o quedar cargando indefinidamente. Además, se incorpora la fecha y hora de cada petición en el listado de conversaciones, facilitando su identificación y reapertura posterior. También se mejora la gestión de errores, mostrando información más clara cuando una solicitud no puede completarse correctamente.
Se corrige un error en la tabla de información de Packs que provocaba una representación incorrecta de la barra de progreso al ordenar los datos de menor a mayor. A partir de esta versión, los valores y su representación visual se actualizan correctamente tras aplicar la ordenación.
Se incorpora la posibilidad de seleccionar un rango específico dentro del área de Forecast en las gráficas de métricas. Esta mejora permite acotar el intervalo de interés y analizar con mayor precisión los valores previstos dentro del periodo seleccionado.
Se corrige un error por el que el filtro de fecha de Event Correlator se enviaba vacío por defecto. A partir de esta versión, el filtro se inicializa automáticamente con el intervalo correspondiente a las últimas 24 horas.
Se corrige un error que provocaba el fallo en Informes de Multimétricas (Multimetrics) cuando el campo
metric_valuerecibí un array vacío. A partir de esta versión, estos casos se gestionan correctamente, evitando que el informe se interrumpa.
Software actualizado
Como siempre, otras piezas de software se han incorporado y actualizado en esta nueva versión de WOCU-Monitoring:
Software |
Versión anterior |
Versión actual |
Observaciones |
|---|---|---|---|
Grafana |
11.6.2 |
11.6.14+security-04 |
https://github.com/grafana/grafana/blob/main/CHANGELOG.md#11614security-04-2026-05-12 |
MongoDB |
4.4.30 |
4.4.31 |
https://www.mongodb.com/try/download/community-edition/releases |
mosquitto |
2.0.21-1 |
Software de nueva implementación. |
|
mosquitto-clients |
2.0.21-1 |
Software de nueva implementación. |
Sobre WOCU-Monitoring
WOCU-Monitoring es una herramienta de monitorización multipropósito que integra las últimas tecnologías Open Source de monitorización, visualización, graficado de métricas y gestión de logs, proporcionando una amplia visibilidad sobre el estado y disponibilidad de elementos de red, servidores, bases de datos y estaciones de trabajo (entre otros) utilizando para ello Packs de Monitorización a medida.
Además de la versión Free, la versión de WOCU-Monitoring denominada Enterprise permite realizar despliegues de miles de dispositivos IP, en un entorno distribuido, con personalizaciones adaptadas a la infraestructura de cada cliente.